

Por que sistemas com IA exigem observabilidade semântica?
Em software convencional, o monitoramento avisa quando o processo quebra. Em sistemas com modelos de linguagem, o servidor responde verde enquanto o agente alucina.
PorErick Mendes
15 min de leitura
Seções deste artigo
Resumo
- O APM tradicional mede disponibilidade de processo, não correção de comportamento. Um sistema com LLM pode registrar status
200 OKcom latência de 600 ms e, ainda assim, entregar uma resposta prejudicial, vazar dados protegidos ou executar chamadas de ferramentas desnecessárias. - A observabilidade em IA opera em quatro pilares: rastreio de execução e ferramentas (tracing), governança financeira de tokens, avaliação contínua da qualidade (evals) e auditoria regulatória.
- A Gartner projeta que mais de 40% dos projetos de IA agêntica serão cancelados até o fim de 2027 por custos descontrolados, valor de negócio nebuloso e controles de risco inadequados. Nenhum desses fatores decorre de o modelo ser fraco, mas sim da falta de visibilidade sobre o que o sistema realmente faz.
- Na Síntese Labs, a observabilidade é um pilar fundamental. Instrumentamos traces e métricas para que a telemetria não seja vaidade de dashboard, mas o sensor que calibra o harness e retroalimenta o método.
O painel verde que esconde uma fatura de três mil dólares
Imagine uma segunda-feira comum em uma equipe de engenharia. O painel do Prometheus ou do Datadog exibe métricas impecáveis: consumo de CPU abaixo de 30%, uso de memória previsível, tempo de resposta p95 em 780 milissegundos e taxa de erros HTTP 5xx cravada em 0,01%. Para qualquer padrão histórico de confiabilidade de sistemas (SRE), a operação está em estado de excelência.
No entanto, no suporte ao cliente, dezenas de mensagens começam a acumular: o assistente agêntico do produto passou a responder aos usuários que uma funcionalidade contratada não existe mais. Ao mesmo tempo, na fatura da API do provedor de modelos, um alerta de consumo disparou: um único fluxo de triagem entrou em um ciclo de 18 chamadas de ferramenta redundantes por requisição, reenviando o histórico completo de mensagens a cada passo.
O software não caiu. O container não sofreu reinicialização por falta de memória (OOM kill). Nenhum panic apareceu nos logs do servidor. Em termos de infraestrutura clássica, tudo funcionou perfeitamente. Em termos de produto e negócio, o sistema quebrou por completo.
Esse cenário resume o ponto cego central da engenharia de software contemporânea: a métrica clássica de disponibilidade de infraestrutura não avalia a fidelidade de um sistema não-determinístico. Quando colocamos modelos de inteligência artificial generativa no caminho crítico de uma aplicação, a observabilidade deixa de ser uma questão de saber se o servidor está de pé e passa a ser o único meio de enxergar o que o modelo pensou, quais ferramentas chamou, quanto custou e onde ele começou a se desviar.
O que o APM tradicional não consegue enxergar
Durante três décadas, monitorar sistemas web significava responder a três perguntas objetivas: o serviço respondeu? Em quanto tempo? A resposta quebrou o protocolo esperado?
Para isso, o tripé clássico de métricas, logs e traces distribuídos (APM) consolidou convenções eficientes. Se uma função do banco de dados demorar dois segundos ou lançar uma exceção de conexão, a linha correspondente no log acusa o erro com o stack trace exato e a causa raiz.
Em sistemas que operam com modelos probabilísticos e agentes autônomos, esse modelo mental colapsa. O modelo não emite um código de erro quando inventa um parâmetro que não consta na documentação. Ele simplesmente formata a alucinação em Markdown impecável, inclui referências verossímeis e retorna com sucesso HTTP.
Dimensão | Observabilidade tradicional (APM) | Observabilidade em sistemas com IA |
|---|---|---|
Sinal primário de falha | Códigos HTTP 500, exceções não tratadas, crashes de processo | Respostas alucinadas, desvio de diretrizes (jailbreak), loops de raciocínio |
Determinismo | Mesma entrada e mesmo estado geram a mesma saída | A mesma entrada pode gerar execuções, tempos e saídas distintas |
Custo de execução | Quase constante por requisição (computação amortizada em nuvem) | Extremamente variável (volume de tokens, histórico acumulado e chamadas de ferramentas) |
Ponto de gargalo | Bloqueio de I/O em banco de dados, locks de memória e throughput de rede | Janela de contexto saturada, latência de primeiro token (TTFT) e ferramentas lentas |
Inspeção de auditoria | Parâmetros de entrada e resposta de APIs serializadas (JSON/gRPC) | Prompt do sistema, contexto recuperado (RAG), passos de raciocínio e payloads de ferramentas |
Sem instrumentação desenhada para IA, uma equipe opera no escuro. Ela descobre que o sistema falhou apenas quando o cliente reclama na rede social ou quando a diretoria financeira bloqueia o cartão corporativo pelo estouro de cota da API.
A mortalidade precoce dos agentes e o custo invisível
A corrida para empacotar chamadas de modelos em fluxos de trabalho autônomos gerou uma onda de expectativas infladas. Segundo levantamento da Gartner, mais de 40% dos projetos corporativos de IA agêntica correm o risco de serem cancelados até o final de 2027 (Gartner (abre em outra aba)).
As três causas principais identificadas pela consultoria não mencionam a falta de capacidade cognitiva dos modelos. Os motivos de fracasso são: escalada descontrolada de custos, ausência de clareza no valor de negócio e controles inadequados de risco.
Todas essas causas apontam diretamente para a ausência de observabilidade.
Considere a dinâmica de consumo de tokens em arquiteturas agênticas. Em um script tradicional de microsserviço, processar dez registros custa dez vezes o tempo unitário de CPU. Já em um agente de raciocínio que decide autonomamente quais ferramentas disparar, o custo não cresce de forma linear.
Se o prompt acumula o histórico de cada rodada de pensamento e chamada de ferramenta sem compactação, o volume de tokens de entrada cresce em progressão aritmética a cada iteração:
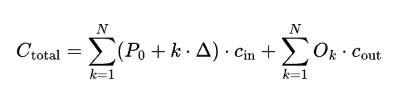
Onde P0 é o prompt inicial, Δ é o volume médio de contexto adicionado por cada passo de ferramenta, N é o número de interações e c representa o custo unitário por token.
Basta que o modelo hesite ou receba uma saída ambígua de uma ferramenta para que N escale de três para quinze passos. Em questão de segundos, uma tarefa estimada em dois centavos consome dois dólares. Multiplique isso por centenas de usuários concorrentes e a conta do provedor de inteligência artificial inviabiliza a margem do produto antes mesmo do fim do primeiro ciclo de cobrança.
Sem uma camada de telemetria capaz de quebrar esse custo por tipo de tarefa, versão de prompt, modelo utilizado e usuário final, qualquer tentativa de otimização vira mero palpite.
As quatro camadas que tornam um sistema com IA observável
Na experiência de engenharia que desenvolvemos na Síntese Labs, a observabilidade não pode ser reduzida a um gráfico genérico de total de tokens consumidos. Para que ela sirva à tomada de decisão técnica, precisa ser dividida em quatro camadas funcionais:
1. Tracing de execução, subagentes e chamadas de ferramenta
O rastreamento em IA decompõe a cadeia de raciocínio em etapas discretas (spans). Cada vez que o sistema toma uma decisão, a observabilidade precisa registrar:
- O prompt de sistema exato enviado, com as variáveis injetadas.
- O contexto retornado pela base de conhecimento (quais fragmentos de documentos foram recuperados pelo RAG e qual a pontuação de similaridade de cada um).
- O nome da ferramenta acionada, os parâmetros gerados pelo modelo e o retorno cru da ferramenta.
- A árvore de chamadas caso um agente tenha delegado tarefas a subagentes paralelos.
Esse nível de detalhe é o que permite identificar falhas silenciosas de integração. É comum que uma API externa retorne um aviso semântico de erro formatado como texto normal e que o modelo, sem acusar falha, tente improvisar uma resposta fictícia para preencher a lacuna. Sem rastreio dos dados crus trafegados na chamada da ferramenta, o desenvolvedor perde horas tentando ajustar o prompt quando o problema real está na serialização de um parâmetro do endpoint.
2. Governança financeira e métricas de desempenho temporal
Medir custo em IA exige granularidade contábil. Uma plataforma profissional de telemetria deve associar cada centavo gasto a tags de negócio: qual cliente gerou a despesa, qual funcionalidade disparou a inferência e qual versão do fluxo estava rodando.
Além do custo financeiro, a dimensão temporal possui especificidades que o APM genérico ignora:
- Time-to-First-Token (TTFT): o tempo decorrido até o modelo começar a gerar o primeiro caractere da resposta. Essa métrica mede a percepção imediata de agilidade pelo usuário.
- Tokens por segundo (TPS): a velocidade contínua de geração do modelo durante a transmissão (streaming).
- Latência de ferramentas acumulada: quanto do tempo total da requisição foi consumido esperando bancos de dados ou APIs corporativas, e quanto foi tempo de inferência neural propriamente dita.
Quando o sistema começa a parecer lento para os usuários, essas métricas revelam sem ambiguidade se a lentidão decorre da sobrecarga nos servidores do provedor do modelo ou se o nosso próprio mecanismo de busca semântica está demorando excessivamente para montar o contexto de entrada.
3. Avaliação semântica contínua (Online Evals)
Em desenvolvimento tradicional de software, os testes unitários e de integração rodam antes do merge no pipeline de CI/CD. Se todos passam, o release é liberado com razoável grau de certeza de que o comportamento se manterá idêntico em produção.
Com modelos de linguagem, testes prévios continuam sendo obrigatórios, mas são insuficientes. O modelo interage com uma infinidade de formulações de linguagem natural que nenhum conjunto de testes sintéticos consegue antecipar.
A observabilidade semântica introduz a figura das avaliações em tempo de execução:
- Aderência ao contexto (Groundedness / Faithfulness): a resposta final se apoia exclusivamente nas informações fornecidas pelo RAG, ou introduziu fatos externos não comprovados?
- Relevância da resposta (Answer Relevance): o texto gerado de fato atende à necessidade expressa pelo usuário, ou foi apenas uma resposta prolixa que tangenciou a dúvida?
- Taxa de recusa adequada: o modelo recusou responder solicitações perigosas sem entrar em recusas excessivas para perguntas de negócio válidas (false positive safety triggers)?
Essas avaliações podem ser executadas de forma assíncrona, usando modelos menores e mais rápidos atuando como juízes (LLM-as-a-judge) sobre uma amostra estatística das requisições reais. O resultado não é uma sensação subjetiva de que o sistema "está funcionando bem", mas um indicador numérico percentual que acusa imediatamente se uma alteração recente no prompt de sistema degradou a precisão das respostas.
4. Rastreabilidade, conformidade e o imperativo regulatório
A necessidade de observar sistemas com IA ultrapassa a eficiência técnica; ela é hoje uma exigência jurídica e regulatória.
A Lei Geral de Proteção de Dados Pessoais (LGPD), em seu artigo 20, estabelece com clareza o direito do titular de solicitar a revisão de decisões tomadas unicamente com base em tratamento automatizado de dados pessoais que afetem seus interesses, cabendo ao controlador fornecer informações claras sobre os critérios e procedimentos utilizados. Diretrizes internacionais similares, como o Regulamento de Inteligência Artificial da União Europeia (EU AI Act), impõem padrões rigorosos de registro de logs técnicos e explicabilidade para sistemas classificados como de alto risco.
Se uma empresa não mantém um registro imutável que relacione a resposta concedida a um cidadão ao prompt original, aos documentos recuperados no contexto e à versão exata do modelo utilizada naquele minuto, ela não tem como auditar nem defender juridicamente a decisão tomada. A observabilidade é o alicerce técnico que viabiliza essa prestação de contas.
O GIRO: como a Síntese Labs trata observabilidade na prática
A Síntese é um venture studio com comunidade tech própria, que desenvolve produtos e startups próprios e também presta serviço de software sob medida. O nosso serviço de levar esse método para o cliente se chama Implantação do Método.
Em nossa metodologia, a observabilidade não é uma ferramenta isolada instalada no fim do cronograma. Ela constitui a letra final do GIRO — nosso padrão de governança de engenharia que reúne:
- Governança: a garantia de que decisões críticas passam por validação humana (human-in-the-loop) e que o agente nunca avança etapas contratuais ou faz deploys sem supervisão.
- Interpretabilidade: a prática de exigir justificativas legíveis para cada decisão de arquitetura tomada pelo agente.
- Rastreabilidade: o vínculo formal entre cada linha de código, documento gerado, autor e data.
- Observabilidade: a mensuração contínua e detalhada de ações, ferramentas e custos de cada agente no sistema.
No ecossistema de ferramentas que utilizamos, a observabilidade é centralizada no Langfuse. Optamos pelo Langfuse por ser uma plataforma de código aberto (licença MIT no núcleo), extensível, aderente às convenções do ecossistema OpenTelemetry e que permite auto-hospedagem (self-hosting). Essa última característica é indispensável quando lidamos com produtos e clientes cujos dados não podem trafegar por servidores de terceiros sem controle rigoroso de perímetro de segurança.
Toda interação executada pelos agentes — seja durante a fase de especificação com o Blueprint, seja na execução paralela em múltiplos repositórios com o Playmaker — registra seus passos no Langfuse. Isso cria um ativo permanente que chamamos internamente de Data Flywheel:
Quando um squad conclui um projeto, a análise dos registros de observabilidade revela exatamente onde o agente desperdiçou iterações, quais instruções de arquitetura foram mal interpretadas e quais ferramentas falharam silenciosamente. Essas evidências não se perdem na memória dos desenvolvedores: elas entram formalmente no fechamento do projeto (Retro de Projeto) e viram ajustes diretos nas instruções de trabalho (playbooks) e nas restrições rígidas (hard rules) dos projetos seguintes.
O agente melhora não porque passamos a torcer para o modelo acertar, mas porque o sensor de observabilidade mostrou com precisão milimétrica onde o ambiente ao redor dele precisava ser reforçado.
O que a observabilidade NÃO resolve
É fundamental deixar claro o que a observabilidade não faz por um sistema:
- Observabilidade não corrige arquiteturas defeituosas. Uma telemetria de primeiro nível apenas documenta a falha com riqueza de detalhes. Se o prompt de sistema contém instruções contraditórias, se o particionamento de documentos do RAG quebra frases ao meio ou se as ferramentas disponíveis devolvem payloads gigantescos e poluídos, o sistema continuará falhando. O dashboard acusará o problema, mas a correção continuará dependendo de refatoração humana de engenharia.
- Avaliadores automáticos (LLM-as-a-judge) têm margem de erro e geram custo adicional. Usar um segundo modelo para avaliar se o primeiro modelo alucinou não é um teste matemático determinístico. O modelo avaliador pode cometer erros de interpretação, sofrer de viés de concordância (sycophancy) e adiciona uma sobretaxa financeira à operação. Por essa razão, consideramos avaliações automáticas como termômetros probabilísticos de tendência, e não como provas formais de conformidade. A amostragem humana periódica de casos críticos continua sendo indispensável.
- Instrumentar telemetria introduz preocupações reais de privacidade. Gravar na íntegra prompts, saídas e dados de ferramentas significa armazenar potencialmente dados pessoais (PII) e informações confidenciais de negócio em uma base de traces. Se a equipe não configurar rotinas rígidas de sanitização, mascaramento e controle de retenção de dados antes de enviar as cargas para a plataforma de observabilidade, a ferramenta criada para garantir a governança passará a ser, ela própria, a fonte primária de vazamento de dados.
O que fazer agora?
Se a sua equipe já possui sistemas com IA em produção ou está se preparando para lançar um produto agêntico, sair do escuro não exige meses de planejamento teórico. Três decisões práticas alteram a maturidade da sua operação já na próxima semana:
- Separe o tráfego de infraestrutura da telemetria semântica: Mantenha o seu monitoramento tradicional (Datadog, Grafana, CloudWatch) cuidando de CPU, memória e requisições HTTP da API. Mas conecte imediatamente um SDK especializado (como Langfuse ou bibliotecas aderentes ao padrão OpenInference) nas chamadas do modelo. A primeira vitória visível é passar a inspecionar o fluxo completo de uma requisição de ponta a ponta: do prompt enviado ao retorno exato de cada ferramenta.
- Defina travas financeiras rígidas por sessão (hard spending limits): Nunca suba um agente com chamadas de ferramentas recursivas sem um limite imutável de interações por requisição (ex.: no máximo 8 voltas de raciocínio) e um teto de custo financeiro estimado por execução. O agente que não encontra a resposta deve falhar com graciosidade e pedir esclarecimento ao usuário, em vez de continuar buscando eternamente no banco vetorial até queimar o saldo da sua chave de API.
- Monitore a deriva de comportamento ao atualizar modelos: Antes de trocar a versão de um modelo no seu arquivo de configuração, capture uma amostragem de 50 casos reais rastreados na sua base de traces e rode como régua de comparação. Modelos atualizados mudam a sensibilidade à formatação e ao uso de ferramentas. O que funcionava com 98% de precisão pode cair para 80% em produção sem que nenhuma linha de código da sua aplicação tenha sido modificada.
Desenvolver com inteligência artificial não dispensa as boas práticas consolidadas da engenharia de software tradicional. Pelo contrário: ao introduzir componentes estatísticos no cerne da arquitetura de sistemas, a disciplina de medição precisa se tornar ainda mais rigorosa.
Quando o código deixa de ser puramente determinístico, a observabilidade deixa de ser um luxo e assume o papel de fronteira entre construir um produto confiável de longo prazo ou apenas torcer para que a máquina não erre.
Participe da discussão
Acompanhar a evolução das práticas de engenharia de software e governança para a era agêntica é um dos compromissos da Síntese Labs. Se você constrói com agentes, gerencia equipes técnicas ou enfrenta o desafio de colocar modelos em produção com segurança, venha discutir métodos, padrões e ferramentas reais em nossa comunidade: sinteselabs.com/comunidade (abre em outra aba).
Fontes
- Gartner: Gartner Predicts Over 40 Percent of Agentic AI Projects Will Be Canceled by End of 2027, comunicado de imprensa global (artigo da Gartner (abre em outra aba)).
- Langfuse: Documentação oficial sobre observabilidade de LLMs, métricas de tokens e rastreamento de traces e spans (documentação do Langfuse (abre em outra aba)) e repositório oficial de código aberto sob licença MIT (repositório GitHub (abre em outra aba)).
- OpenTelemetry: Especificações semânticas para Grandes Modelos de Linguagem e convenções de instrumentação para GenAI (Semantic Conventions for Generative AI Operations) (OpenTelemetry AI Conventions (abre em outra aba)).
- Brasil: Lei Geral de Proteção de Dados Pessoais (LGPD), Lei nº 13.709/2018, em especial o Artigo 20 sobre revisão de decisões automatizadas (Portal da Legislação (abre em outra aba)).
- NIST: Artificial Intelligence Risk Management Framework (AI RMF 1.0), Instituto Nacional de Padrões e Tecnologia dos EUA (publicação do NIST (abre em outra aba)).
Quem escreveu
Escrito por Erick Mendes.
Erick Mendes
Produto e Capacitação
Sócio da Síntese Labs. Escreve sobre a evolução da Inteligência Artificial no Brasil.
LinkedInContinuar lendo
Engenharia e stack
Como a maneira com que lidamos com orquestração de agentes é única.
Como a Síntese Labs transforma práticas e ferramentas do desenvolvimento agêntico global em soluções próprias, antecipando tendências e aproximando essas tecnologias do mercado brasileiro.
Projetos da Síntese
Os desafios de desenvolver serviços GovTech
Da integração de dados públicos à inteligência artificial, o que aprendemos construindo um produto para aproximar o Congresso de quem precisa entendê-lo.
Projetos da Síntese
Aprendendo a usar IA na ingestão de dados
Em projetos AI First, nem sempre é necessário colocar IA em tudo.
Tem um problema parecido para resolver?
A Síntese constrói software sob medida e capacita times em desenvolvimento agêntico, com cada etapa observável e rastreável.
Falar com a Síntese